puding 🥣 — model results
LLM benchmark on a GB10 (Nvidia Spark GX10, 128GB unified memory). Each model gets the same coding prompts via an OpenAI-compatible API; I record speed and token usage, and keep the generated artifact (an SVG or a single-file app) so you can open it below. Github: https://github.com/polaroi8d/puding
Ornith-1.0-35B
| Prompt | TTFT | Total Time | Prompt Tok | Completion Tok | Total Tok | Speed |
|---|
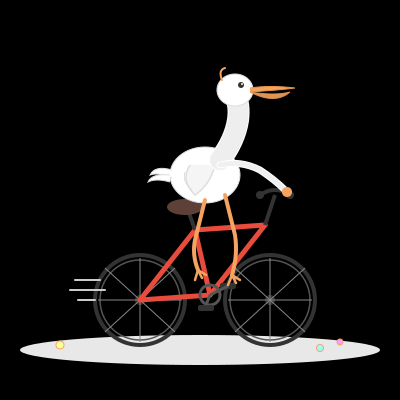
| SVG Pelican on a Bicycle | 0.381s | 106.251s | 65 | 3168 | 3233 | 29.8 tok/s |
| Todo App | 0.702s | 77.964s | 1122 | 2305 | 3427 | 29.6 tok/s |
Qwen/Qwen-AgentWorld-35B-A3B
| Prompt | TTFT | Total Time | Prompt Tok | Completion Tok | Total Tok | Speed |
|---|
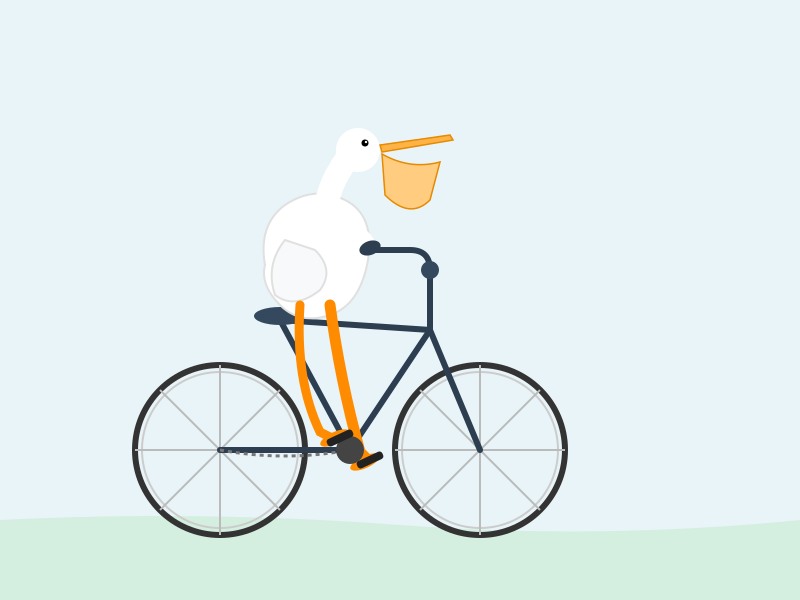
| SVG Pelican on a Bicycle | 1.442s | 528.341s | 65 | 15552 | 15617 | 29.4 tok/s |
| Todo App | 1.923s | 336.832s | 1122 | 9909 | 11031 | 29.4 tok/s |
Qwen/Qwen3-Coder-30B-A3B-Instruct-FP8
Qwen/Qwen3.6-35B-A3B
| Prompt | TTFT | Total Time | Prompt Tok | Completion Tok | Total Tok | Speed |
|---|
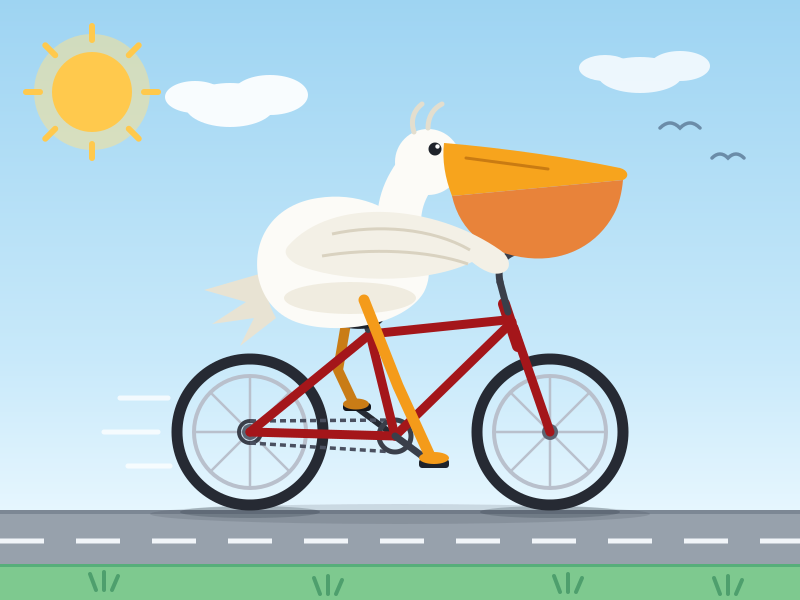
| SVG Pelican on a Bicycle | 1.501s | 264.784s | 65 | 7720 | 7785 | 29.2 tok/s |
| Todo App | 2.129s | 87.112s | 1122 | 2560 | 3682 | 29.4 tok/s |
Qwen3-Coder-Next-FP8
| Prompt | TTFT | Total Time | Prompt Tok | Completion Tok | Total Tok | Speed |
|---|
| SVG Pelican on a Bicycle | 0.386s | 38.387s | 63 | 1822 | 1885 | 47.5 tok/s |
| Todo App | 0.844s | 50.049s | 1082 | 2346 | 3428 | 46.9 tok/s |
mistralai/Codestral-22B-v0.1
openai/gpt-oss-20b
qwen38-27b-unsloth-nvfp4
| Prompt | TTFT | Total Time | Prompt Tok | Completion Tok | Total Tok | Speed |
|---|
| SVG Pelican on a Bicycle | 1534.338s | 1735.15s | 103 | 31595 | 31698 | 18.2 tok/s |
| Todo App | 773.128s | 1007.585s | 1160 | 19757 | 20917 | 19.6 tok/s |